FROID Psique / Tecnología
El valor de un registro comienza en su origen. FROID separa las características vocales, las estimaciones faciales y la interpretación clínica para que una capa no se confunda con otra.
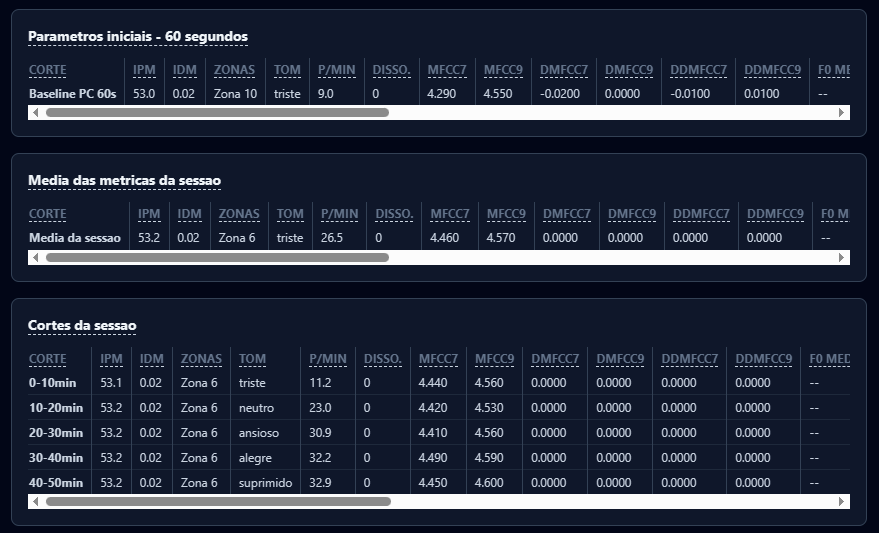
Los primeros 60 segundos de calibración establecen la referencia vocal. La distribución de la energía en 12 bandas se sigue en relación con la sesión; características como F0, MFCC y ZCR integran la lectura acústica disponible.
Compárelo con una regla: permite seguir variaciones, pero no da, por sí sola, un significado clínico a lo que cambió. Una banda de frecuencia no corresponde a una emoción validada.
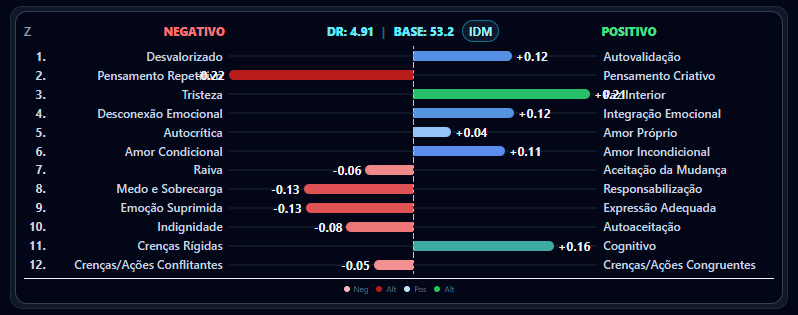
En la composición actual, el IPM organiza la magnitud de los desvíos acústicos en relación con la referencia. El IDM preserva la dirección media de esos desvíos, diferenciando aumentos y reducciones de energía.
Los nombres de los índices se mantienen en el producto, pero su composición actual es vocal. La interpretación facial se presenta aparte: no activa marcas en las bandas, no multiplica desvíos y no comprueba conflicto entre rostro y discurso.
Entienda cómo se distinguen el cálculo y la validación clínica.
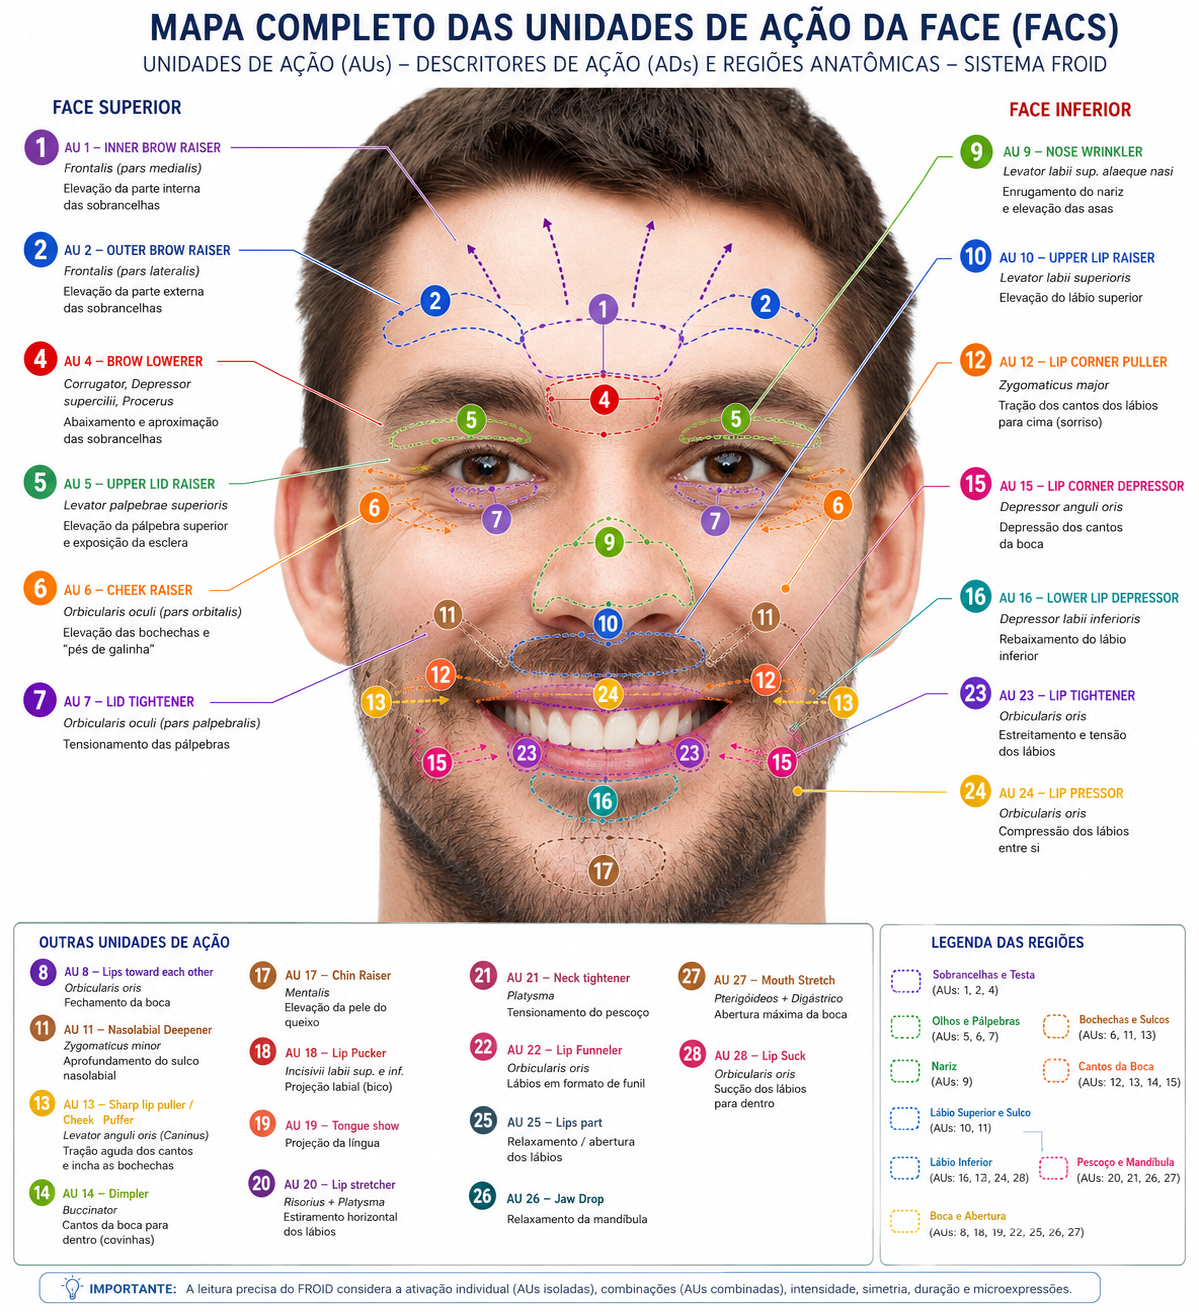
El navegador extrae coeficientes numéricos del video autorizado del paciente. Un único motor en el servidor produce estimaciones de Unidades de Acción e interpreta combinaciones, preservando la lateralidad y las ambigüedades.
El contrato mantiene 16 campos. Quince tienen mapeos aproximados, dependientes de los coeficientes recibidos. AU23 permanece no apurada. AU17 utiliza mouthShrugLower como proxy; AU23 no se deriva de la inversión labial. AU25 y AU27 no están instrumentadas. Los coeficientes brutos y las estimaciones heredadas se preservan sin convertir la ausencia en un valor ficticio.
Estas estimaciones no equivalen a una codificación FACS certificada. Las combinaciones se organizan en siete familias de patrones compatibles.
Preservar la ambigüedad evita elegir una familia solo por el orden de las reglas. Exigir repetición puede dejar pasar expresiones muy breves; eso no es una certificación de detección de microexpresiones.
La extracción facial en el navegador, la interpretación en el servidor y el procesamiento vocal en infraestructura dedicada componen la arquitectura definida para esta versión. La transmisión de la videollamada y el flujo del análisis facial son recorridos distintos.