FROID Psique / Technologie
La valeur d'un registre commence par son origine. FROID sépare les caractéristiques vocales, les estimations faciales et l'interprétation clinique pour qu'une couche ne soit pas confondue avec une autre.
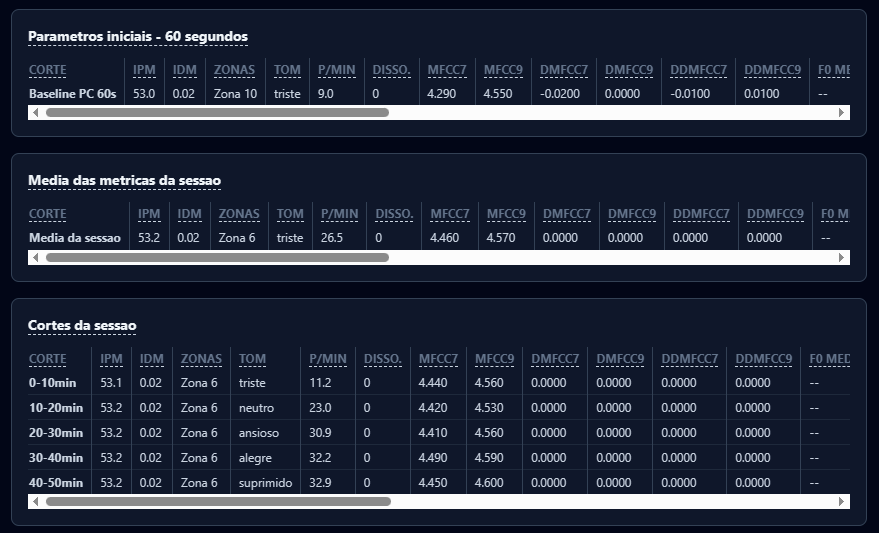
Les 60 premières secondes d'étalonnage établissent la référence vocale. La distribution de l'énergie en 12 bandes est suivie par rapport à la séance ; des caractéristiques comme F0, MFCC et ZCR font partie de la lecture acoustique disponible.
Comparez avec une règle : elle permet de suivre des variations, mais ne donne pas, à elle seule, de signification clinique à ce qui a changé. Une bande de fréquence ne correspond pas à une émotion validée.
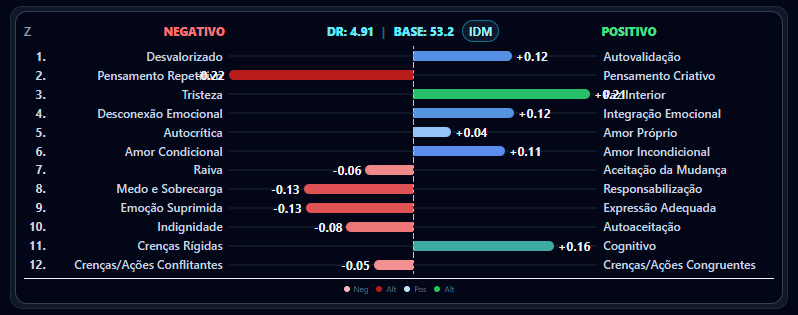
Dans la composition actuelle, l'IPM organise l'amplitude des écarts acoustiques par rapport à la référence. L'IDM préserve la direction moyenne de ces écarts, en distinguant les hausses et les baisses d'énergie.
Les noms des indices sont conservés dans le produit, mais leur composition actuelle est vocale. L'interprétation faciale est présentée à part : elle n'actionne pas de marques dans les bandes, ne multiplie pas les écarts et ne prouve pas de conflit entre visage et discours.
Comprenez comment se distinguent calcul et validation clinique.
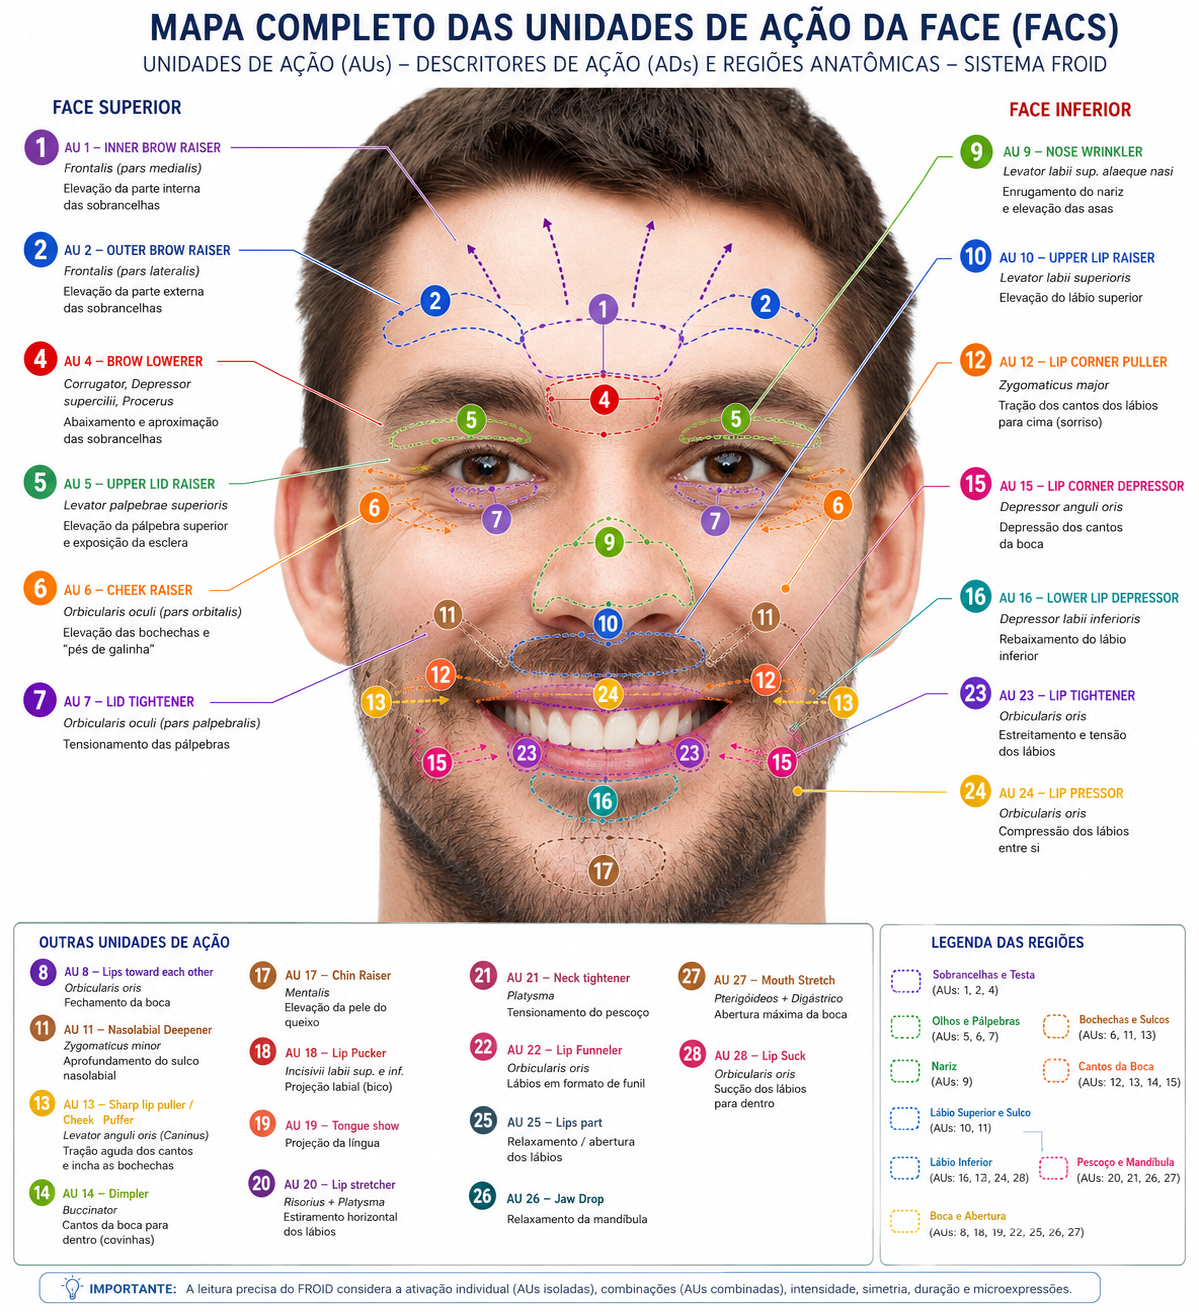
Le navigateur extrait des coefficients numériques de la vidéo autorisée du patient. Un moteur unique sur le serveur produit des estimations d'Unités d'Action et interprète des combinaisons, en préservant la latéralité et les ambiguïtés.
Le contrat maintient 16 champs. Quinze ont des correspondances approximatives, dépendantes des coefficients reçus. L'AU23 reste non déterminée. L'AU17 utilise mouthShrugLower comme proxy ; l'AU23 n'est pas dérivée du roulement labial. Les AU25 et AU27 ne sont pas instrumentées. Les coefficients bruts et les estimations héritées sont préservés sans convertir l'absence en valeur fictive.
Ces estimations n'équivalent pas à un codage FACS certifié. Les combinaisons sont organisées en sept familles de motifs compatibles.
Préserver l'ambiguïté évite de choisir une famille uniquement selon l'ordre des règles. Exiger la répétition peut laisser passer des expressions très brèves ; ce n'est pas une certification de détection de micro-expressions.
L'extraction faciale dans le navigateur, l'interprétation sur le serveur et le traitement vocal sur une infrastructure dédiée composent l'architecture définie pour cette version. La transmission de la visioconférence et le flux de l'analyse faciale sont des parcours distincts.